


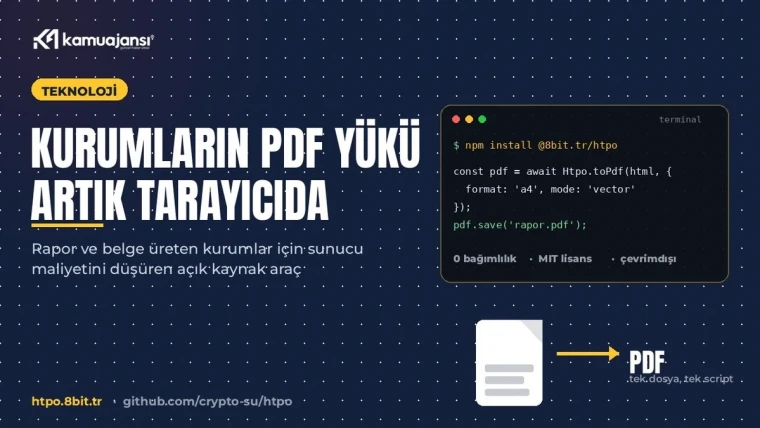
Kamu kurumlarında rapor, tutanak ve belge üretiminin son adımı çoğu yerde hâlâ aynı: HTML olarak hazırlanan sayfa sunucuya gönderiliyor, orada PDF'e çevriliyor ve kullanıcıya indiriliyor. Bu işi yapan yaygın araçların başında uzun yıllardır wkhtmltopdf geliyor. htpo (HTML to PDF Offline) adlı yeni bir açık kaynak kütüphane bu adımı sunucudan çıkarıp doğrudan tarayıcının içine taşıyor. Yani belgeyi üreten işlemci gücü, kurumun sunucusundan ziyaretçinin kendi bilgisayarına geçiyor. Konu, teknoloji sayfamızda izlediğimiz dijital dönüşüm başlıklarının tam ortasında duruyor.
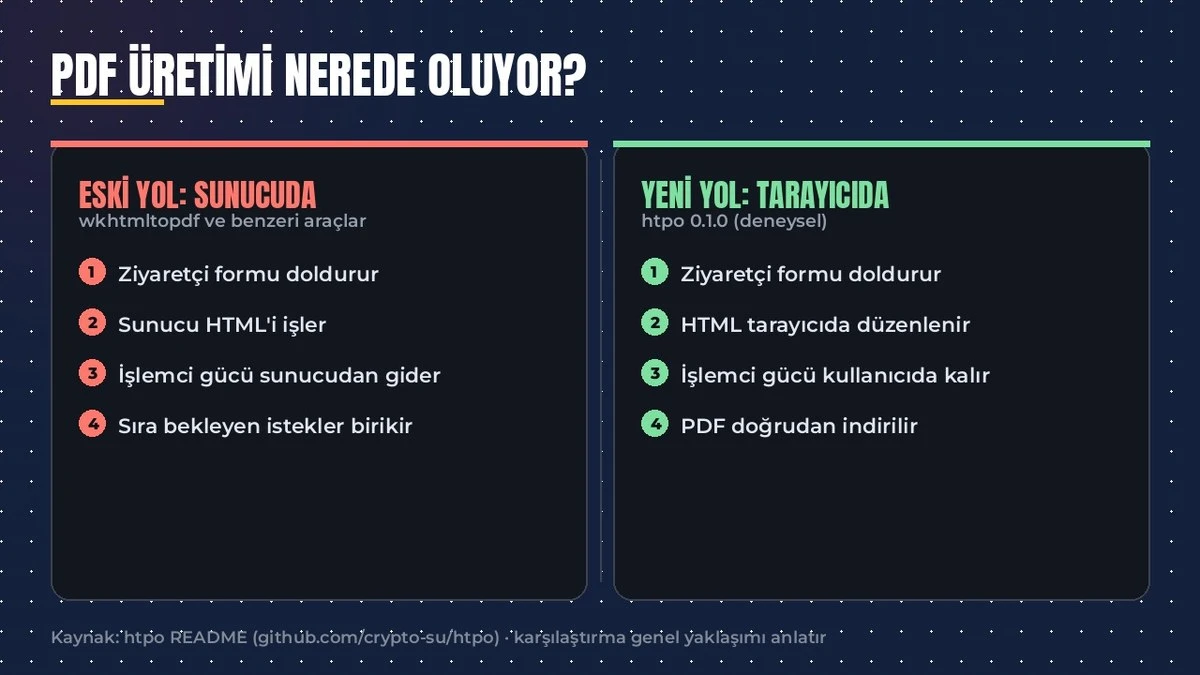
Çıkış noktası basit bir gözlem: personel self servis ekranında aynı anda yüzlerce kişi "belgeyi indir" düğmesine bastığında sunucu her istek için ayrı ayrı HTML düzenlemesi, sayfa bölme ve font gömme işlemi yapıyor. Bu işlemler hafif değil; sıraya giriyor ve kapasite planlamasını zorlaştırıyor. htpo bu yükü doğrudan tarayıcıya veriyor.
Kütüphane MIT lisansıyla yayımlanmış, geliştiricisi Uğur Yıldırım (8bit.tr). npm üzerinde @8bit.tr/htpo adıyla duruyor ve tek bir JavaScript dosyasından oluşuyor. Çalışma zamanında hiçbir ek bağımlılık istemiyor; PDF motoru ve varsayılan fontlar aynı dosyaya gömülü. Bu, dış kütüphane zinciri ve sürüm çakışması derdini de ortadan kaldırıyor.
Kurulum ve ilk kullanım
Kurulum, npm komutuyla tek satırda yapılıyor; derleme adımı yok:
npm install @8bit.tr/htpoTarayıcıya jsDelivr üzerinden tek bir script etiketiyle de eklenebiliyor. Kullanım kısa:
const pdf = await Htpo.toPdf(html, {
  format: 'a4',
  mode: 'vector'
});
pdf.save('rapor.pdf');
Dönen nesne, dosyayı indirmenin yanında blob olarak da alınabiliyor. Kaynak kod github.com/crypto-su/htpo adresinde.
Kurum açısından ne anlama geliyor?
Memur tarafında fark en çok "belgeyi indir" düğmesinde hissediliyor. Sunucu taraflı üretimde istek kuyruğa giriyor ve ay sonu, bordro dönemi, sınav sonuç açıklaması gibi talebin patladığı günlerde bekleme uzuyor; tarayıcı taraflı üretimde belge kullanıcının kendi makinesinde oluşuyor ve araya giren bir sıra kalmıyor. İkinci başlık gizlilik: belge içeriği hiçbir sunucuya gönderilmiyor, sayfa kullanıcının tarayıcısında düzenlenip aynı yerde PDF'e dönüşüyor. Kişisel veri içeren tutanak ya da sağlık raporu gibi belgelerde bu, verinin kurum dışına çıkmaması anlamına geliyor.
Üçüncüsü sunucu kapasitesi: belge üretimi için ayrılan işlemci ve bellek artık kullanıcı sayısıyla birlikte büyümek zorunda değil. Bir uyarı gerekiyor: bu haber için wkhtmltopdf ile hız ya da maliyet ölçümü yapılmadı; anlatılan fark mimari yaklaşımdan, tasarruf oranı olarak sayıya dönüştürülmedi.
Teknik tarafta neler var?
Kütüphane HTML metnini, HTML artı temel adresi, bir URL'yi ya da sayfadaki bir DOM elemanını girdi olarak kabul ediyor. A4, A3, letter ve milimetre cinsinden özel ölçü; yön, kenar boşluğu ve sayfalama kipi ayarlanabiliyor. İki çıktı kipi var: vektör kipinde metin seçilebilir kalıyor, fontlar gömülüyor, bağlantılar korunuyor; raster kipinde her sayfa görüntü olarak saklanıyor. Arşivleme yapanlar için bu ayrım önemli.
Türkçe karakterler README'de ayrı başlık: gömülü DejaVu Sans fontları Türkçe harfleri destekliyor, testlerde Türkçe metnin korunması ve metin çıkarımı doğrulanmış. Belge üretiminin en can sıkıcı hatalarından biri olan "ş, ğ, İ bozuk çıktı" sorunu bu noktada kapatılmış görünüyor. Eski araçlardan geçecekler için bir de uyumluluk modu var: qt-webkit, eski Qt WebKit düzenini taklit ediyor ve satır yüksekliklerini tam piksele yuvarlıyor; yıllardır wkhtmltopdf ile üretilen şablonların görünümü korunmaya çalışılmış.
Dürüst olalım: deneysel bir sürüm
Sürüm 0.1.0 ve yayımlandığı haliyle "deneysel" etiketli. Depo da yeni: tek bir commit, tek bir yıldız, henüz bir topluluk oluşmamış. htpo'yu kurumun kritik belge akışına doğrudan koymak için erken; önce pilot bir ekranda denenmesi ve çıktıların mevcut şablonlarla karşılaştırılması gerekiyor.
Desteklenmeyen özellikler açıkça listelenmiş: PDF/A arşiv standardı, etiketli ve erişilebilir PDF, form alanları, şifreleme, dijital imza yok. Tam CSS sayfalama davranışı, WOFF/WOFF2 ve değişken fontlar, karmaşık yazı sistemleri de yok; bu durumlarda raster kip öneriliyor. Arşiv mevzuatı PDF/A şartı koyuyorsa araç tek başına yetmiyor. Bir sınır daha: kütüphane tarayıcı DOM'una ihtiyaç duyduğu için Node.js tarafında toplu belge üretiminde kullanılamıyor, yani kullanım alanı ekran başındaki kullanıcı.
Memur için pratik anlamı
Gündelik akışta fark şurada görünür: personel izin formunu doldurup "PDF olarak indir" dediğinde belge anında oluşur, yoğun saatte sunucunun sırasını beklemez. Karar verirken üç soru sorulmalı: belgeler arşiv yönetmeliğine uygun mu, mevcut şablonlar yeni motorda aynı görünüyor mu, sorun çıkarsa eski yönteme ne kadar sürede dönülebilir? Bu üç soru cevaplanmadan kurumsal yayına alınması doğru olmaz.
htpo, Türkiye'den çıkmış, Türkçe karaktere özellikle eğilmiş, tek dosyalık bir açık kaynak proje. Kamu bilişiminde yerli ve açık kaynak bileşen tercihine de denk düşüyor. Ama henüz 0.1.0; heyecanla değil pilotla ilerlemek gerekiyor. Kamu kurumlarında dijitalleşme dosyalarını dijital dönüşüm ve e-Devlet etiketlerimizden izleyebilirsiniz.
Kaynak: htpo proje sitesi (htpo.8bit.tr), GitHub deposu (github.com/crypto-su/htpo) ve README dosyası.
 RSS
